技术书籍精读笔记:C++ High Performance
本文摘要: 《C++高性能编程》一书笔记摘要,重点介绍C++核心概念和性能优化技巧。内容包括:零开销原则、值语义、参数传递规范;auto/decltype使用技巧;移动语义与五法则;RVO/NRVO优化原理;函数对象与lambda表达式实现机制;std::function性能考量;性能分析方法(CPU/I/O绑定区分)。特别强调现代C++特性如移动构造、noexcept修饰、右值引用限定符等在实际开发中的应用,通过代码示例展示如何编写高效C++代码。
前言
本系列的博客将围绕这《C++ High Performance》一书进行简单的记录,因为该书不针对C++的初学者进行编写,涉及的许多内容包含数据结构,CPU和底层源码等,所以该系列博客将不针对基础知识进行讲解,只记录书中存在的许多定义或者容易忽略的细节进行讲解。与往常一样,博客的排版,字体都不变,有问题的同学也可以在评论区与我交流,谢谢!!!
C++概述
本小节是该书的第一章,正如前言所述将不会讲解基础内容,针对定义或者细节进行描述。
1.零开销原则
所谓零开销原则指的是,C++中调用的函数基本上是被广泛认可且性能最优的代码。具体定义如下:
1.对于不要使用的东西,你无需为其付出任何代价
2.对于要使用的东西,你无法编写比它更好的代码
2.值语义
值语义一般用于强调对象的值和状态,而不是对象的身份或地址(符合值语义概念的例子如深拷贝,不会影响被拷贝对象的值)。这允许我们通过值来传递对象,而不是传递对象的引用。(浅拷贝会影响原对象的状态)
3.C++函数中参数的含义
在C++的实现中,函数的参数为不能为空的引用,表示只接受一个已经初始化的对象作为参数。而参数使用指针作为参数,则表示该函数中会处理空对象的情况。
PS:这将对我们编写dll或者提供接口给用户使用时尤为重要,一个基础好的程序员是会通过代码的形式与用户交流
C++必备技能
1.在函数返回值中使用auto
auto关键字用于推导对象的类型,在我们使用基于范围的for循环时经常会使用auto关键字,但是在对函数的返回值中使用auto将影响代码的阅读性,如何在使用auto作为返回值声明的同时又不影响阅读性呢?此时我们可以使用返回类型后置的操作提高阅读性,具体操作如下:
//函数返回值为intauto fun() const->int{}//函数返回值为const intauto fun() const->const int{}//函数返回值为const int&auto fun() const->const int&{}参考上述代码,我们可以很容易的判断这些函数的返回值类型。下面将有一个编写代码的骚操作,个人在开发的时候比较少用,可以学习一下。具体如下:
templeate<typename T>auto fun(T a, T b)->std::vector<T>{ return {a,b};}/* 这里的return相当于把参数a和b通过初始化列表的 方式初始化了一个tsd::vector<T>对象返回*/2.使用decltype(auto)转返回类型
decltype(auto)关键字与auto类似,都是用于自动推导变量的操作。但相较于auto能更正确的返回类型,可以搭配使用std::forward<T>模板函数实现返回值的完美转发,具体如下:
auto fun(int a) { return a; } //返回int类型decltype(auto) fun(int a) { return a; } //返回int类型auto fun(int& a) { return a; } //返回int类型decltype(auto) fun(int& a) { return a; } //返回int&类型以下为decltype(auto)搭配std::forward<T>模板函数实现完美转发的例子:
#include <utility>void process(int& x) { std::cout << "左值" << std::endl;}void process(int&& x) { std::cout << "右值" << std::endl;}template <typename T>void wrapper(T&& arg) { process(std::forward<T>(arg)); //使用std::forward<T>}int main() { int a = 42; wrapper(a); //调用process(int& x),因为'a'是左值 wrapper(42); //调用process(int&& x),因为'42'是右值}3.对变量使用auto
本小节重点并不是如何对变量使用auto,而是在类似于语句auto obj=type{}和type obj{}是等效的,也就是说在使用以上两种方式构造一个type类型的obj对象时,执行的效率是一样的。
4.常量引用
本小节最重要的一句就是:如果常量引用绑定到了临时对象上,那么该临时对象的生命周期将延长至引用的生命周期。例子如下:
class MyClass {public: MyClass() { std::cout << "类被创建" << std::endl; } ~MyClass() { std::cout << "类被析构" << std::endl; }};void function(const MyClass& ref) { //在这个函数中,ref是一个常量引用,它绑定到了一个临时对象上 std::cout << "函数function(const MyClass& ref)被调用" << std::endl;}int main() { { std::cout << "代码块开始" << std::endl; function(MyClass()); // 这里创建了一个临时的 MyClass 对象并传递给了 function std::cout << "代码块结束" << std::endl; } //即使离开了创建临时对象的代码块,临时对象也不会被销毁,因为它绑定到了function中的常量引用上 return 0;}/* 执行的结果如下: 代码块开始 类被创建 函数function(const MyClass& ref)被调用 代码块结束 类被析构*/5.指针的常量传播
我们知道在对函数使用const关键字声明时,代表着该函数不会修改函数体内变量的值,为了引入《指针的常量传播》这一小节,设计了以下代码:
class Foo{public: //该函数被const关键字修饰,不能修改函数体内变量的值 auto fun(int obj) const{ *ptr = obj; /* 但该函数是修改了指针指向地址的值, 而不是修改了指针所指向的地址,可通过编译 */ }private: int* ptr{};}这种情况往往是我们无法接受的,当一个函数被const关键字修饰的时候,应该是指针指向的地址和指向的地址所存储的值都不应该被改变。为了实现这一效果,我们可以使用propagate_const类型对指针进行声明(PS:propagate_const类型仅适用于指针和类指针类)。具体使用参考以下例子:
#include<experimental/propagate_const>class Foo{public: auto fun(int obj) const{ *ptr = obj; //无法通过编译 } auto fun(int* obj) const{ ptr = obj; //无法通过编译 }private: std::experimental::propagate_const<int *> ptr = nullptr;}6.移动语义
相信大家可能跟我一样,在阅读完了《C++ Primer plus》一书后,对所谓的移动语义,移动构造和移动赋值函数还不是很了解。而本小节将带你重新对这些概念进行一个全新的了解。
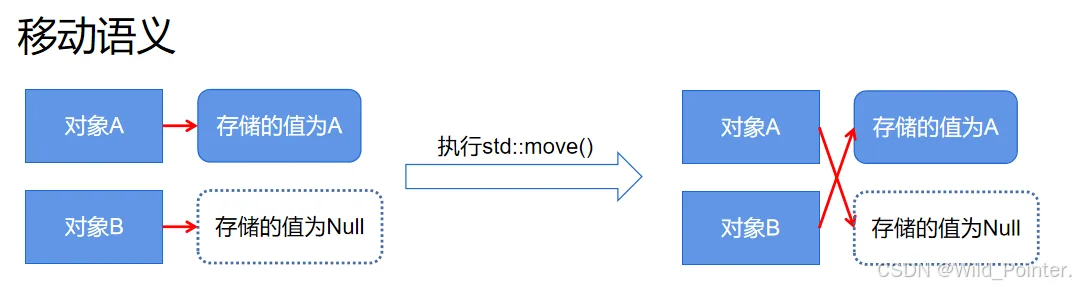
所谓移动语义,其实是将对象的使用权进行移动。也就是说每一个对象都存在一个所谓的使用权的概念,将对象存储的值的使用权移交给其他对象后,当前对象所存储的值将为空。具体概念如下:
图1.移动语义
正如上图所述,此时对象A所存储的值的使用权被移交给了对象B,而对象A的使用权改变为Null,此时再对对象A操作则会报错。这种相互移交使用权的方法也可以通过std::swap()函数进行实现,而这种实现方式不需要调用构造和析构函数,也不需要申请空间,所以移动语义操作的实现方式是最高效的。在移动语义的基础上,我们可以扩展出移动构造函数,如下: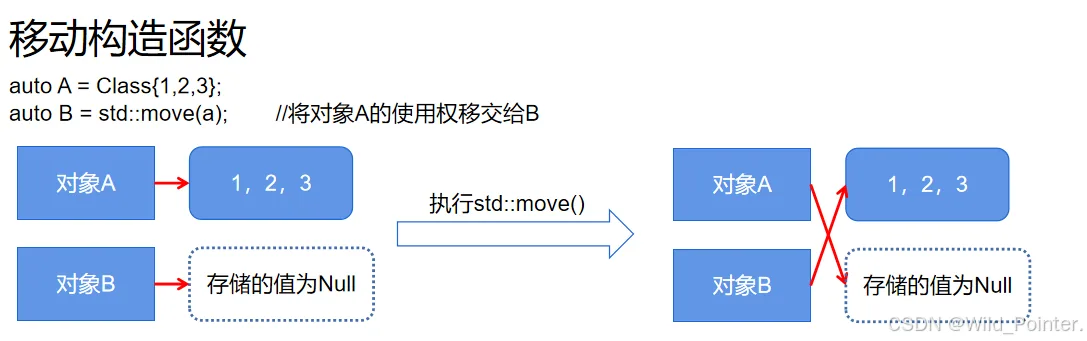
图2.移动构造函数
在了解了移动构造函数以后,移动赋值操作也是如此。所以在定义类的时候,为了更高效的使用对象,可以考虑定义移动构造或移动赋值函数,否则编译器会提供默认的函数。
7.资源获取与五法则
所谓资源获取其实就是移动语义中的使用权,而五法则其实主要指的是以下五个函数:
1.析构函数
2.拷贝构造函数
3.拷贝赋值函数
4.移动拷贝构造函数
5.移动拷贝赋值函数
对于这五个函数,我相信学习C++的同学都不陌生,但是我想很多人跟我对这五个函数的印象都是一样的:在代码中定义这其中一个函数会导致编译器不提供其他四个函数。而其实这取决于编译器,真实的情况是:自定义其中一个特殊成员函数并不会导致编译器不提供其他四个函数,但是自定义某些函数(特别是拷贝构造函数和拷贝赋值函数)会阻止编译器自动生成对应的移动特殊成员函数。
而在这其中,我们提供的移动构造函数和移动赋值运算符需要使用noexcept进行修饰(向编译器声明该函数不会抛出异常)。如果不将它们标记为noexcept,在某一些情况下,标准库中的容器和算法可能无法使用它们,并且只能使用常规的拷贝/赋值操作。而我们在代码中判断一个对象是被移动还是被拷贝,我们需要判断该对象是否存在变量名,存在则被拷贝,否则被移动。而且如果使用std::move()函数来移动一个拥有具体变量名的对象时,那么该对象不能被const关键字修饰。
8.默认移动语义和零法则
本小节主要解释的是所谓的默认移动语义和零法则,而为了简单引入这些概念,我们讨论了生成的拷贝赋值运算符,但是重点可以使用一句话概括:生成的拷贝赋值运算符需要提供强有力的异常保证,无所谓是使用noexcept关键字修饰还是在实现上,假如在拷贝赋值的过程中抛出异常,对象可能最终会处于部分拷贝的状态。
在本小节中,编写了一段十分有趣的代码。如下:
auto operator=(Button&&) noexcept -> Button& = default;对于博主而言,博主见过使用delete关键字修饰这些函数,表明不使用这些函数的。这种写法还是比较少见的。解释如下:该代码重载了一个Button类的移动赋值运算符,接受一个Button类型的右值引用作为参数,保证不会抛出异常,并且返回当前对象的引用。同时使用default关键字指示编译器生成默认的移动赋值运算符。
而所谓的零法则是指:在不需要显示定义(或者使用default声明)以上这些特殊成员函数(此处指的是五法则中的五个函数)的情况下编写自己的类。例如相较于我们在编写代码时,习惯声明空的析构函数,而使用default定义的析构函数或者根本不使用析构函数,这种操作可以从应用程序代码中榨取更多的性能优势。
9.将&&修饰符应用与类成员函数
针对本小节,看代码:
struct Foo{ auto func() && {} //右值引用限定符,表示func只能被右值(即将被销毁或移动的对象)调用}auto a = Foo{};a.func(); //编译错误std::move(a).func(); //编译成功Foo{}.func(); //编译成功这段代码中的Foo结构体中的func()函数被使用&&右值引用限定符修饰,表示func()函数只能被右值引用。
10.RVO优化和NRVO优化
ROV表示返回值优化,而NRVO表示具名返回值优化。这是现代主流的C++编译器都支持的特性。具体如下:
RVO表示运行编译器在某些情况下跳过临时对象的创建,直接在调用函数的上下文中构造返回值,从而避免了不必要的拷贝或者移动操作,优化发生情况:
1.返回值不是引用或者指针
2.返回值是函数内部创建的局部对象
3.函数的返回类型与局部对象的类型完全匹配
NTVO是RVO的特例,发生的情况:
1.函数返回一个局部对象
2.局部对象在函数结束前已经被定义,并且有一个名字
3.局部对象的类型与函数的返回类型完全匹配
11.维护契约
其实所谓的维护契约并不是什么专有名称,只是书中的一个小节的名称罢了。在本小节中主要讲了如何使用断言,以及使用noexcept关键字对性能的影响和类不变式。
断言指的是使用C++标准库中的static_aasert()或者<cassert>中的定义的移植的assert()宏来检测项目的缺陷,具体操作如下:
1.static_assert(obj):用于在编译时判断表达式obj是否正确
2.ASSERT(boj):用于在运行时检查程序逻辑的正确性,在执行宏时,会检查表达式obj的正确性。错则抛出std::assert()异常或打印错误信息并终止程序
可参考以下代码示例:
#ifdef WildPointer#define assert(state) ((void)0) //表示当state为false时,不做任何操作#else#define assert(state)#endeif关于使用noexcept关键字对性能的影响,在被标记有noexcept关键字的函数会使编译器在某些情况下生成速度更快的代码。如果一个被标记为noexcept的函数抛出了异常,那么代码就会调用std::terminate()而不是栈展开。
而所谓的类不变式指的是对象的整个生命周期内的必须保持为真的条件或者属性。确保对象在如何时候都处于一个有效的状态。
12.函数对象和lambda表达式
针对lambda表达式的基础内容,我就不进行讲解了。主要是想补充一个点,就是一个lambds表达式会生成一个函数对象,而这个函数对象则是一个类的实例,在这类中则是重载了操作符()。具体实力如下:
#使用值捕获的lambda表达式auto fun = [x](int y){ return y>x;}#与之等价的类class fun{public: fun(int x):x{x} {} auto operator()(int y) const{ return y>x; }private: int x{};}以上是按值捕获的lambda表达式,而按引用捕获的lambda表达式如下:
#使用引用捕获的lambda表达式auto fun = [&x](int y){ return y>x;}#与之等价的类class fun{public: fun(int& x):x{x} {} auto operator()(int y) const{ return y>x; }private: int& x{};}针对lambda表达式还有一个所谓的花里胡哨的用法,如下:
auto fun = +[](int x){ //具体实现}这段labmbda表达式通常被视为一个匿名的,不可转换为普通函数指针的对象,无法直接将lambda赋给一个接受函数指针的变量,而使用+号这个所谓的一元正好运算符,则可以将lambda函数转换为一个普通的函数指针
13.std::function的性能考量
在涉及到lambda表达式的时候,许多人会想到std::function函数。相比于直接使用lambds表达式构造函数对象,std::function是有性能损失的。
1.一旦设计lambds,编译器是可以对其进行内联调用的,而std::function的灵活设计让编译器几乎无法内联调用被std::function封装的函数。因此频繁调用std::function封装的函数,会对性能产生负面影响
2.如果std::function存储的是带捕获变量或者引用的lambda表达式,那么std::function会使用堆分配的内存来存储捕获的变量,如果捕获的变量大小少于某一个阈值,std::function则不会分配额外的内存。这额外的动态内存分配不仅会导致性能降低,还会因为堆分配的内存增加缓存未命中的次数而导致速度变慢
分析和度量性能
本小节主要讲的是如何分析和度量性能,如果你学过数据结构就知道所谓的空间复杂度和时间复杂度,而本篇的大多数内容也是围绕着这两个名词来进行展开的。本系列博客就默认你已经学习过这些内容,所以本小节将简单补充一些小知识即可
1.I/O绑定或CPU绑定
一个任务通常花费大部分时间在CPU上技术或等待I/O。如果一个任务在CPU更快的情况下就会运行更快,那么该任务被称为CPU绑定。如果让I/O更快,它就越快,那么就是I/O绑定。有时候还会有内存绑定,这就意味着内存的数量或者速度是当前项目的瓶颈
2.采样型分析和插桩型分析
| 特性 | 采样型分析 | 插桩型分析 |
| 数据收集方式 | 定期采样程序状态,如系统日志等 | 插入代码来记录函数的调用,执行时间等 |
| 精度 | 精度低,依赖采样频率 | 精度高,提供详细的数据 |
| 内存 | 占用小 | 占用大 |
| 是否影响程序 | 不影响程序行为 | 影响程序行为,可能增加开支 |
| 使用场景 | 长时间运行的程序,实时监控或生成环境 | 需要详细的性能分析的开发环境 |
本系列的第一章已经结束,个人觉得不是很好。后续看如何调整创作内容,引入更多的特性,更详细的解释