C++高并发内存池实战:PageCache层
本文介绍了C++高并发内存池的PageCache层设计与实现。PageCache层作为内存池的最底层,负责向操作系统申请内存页(Page)并管理CentralCache层的内存分配。文章详细阐述了PageCache的哈希桶结构(包含256个Span双向链表)及其关键接口:NewSpan()用于分配内存,MapObjectToSpan()实现ID映射,ReleaseSpanToPageCache()管理内存释放并处理内存合并。特别针对大于256KB的大内存申请,采用直接向OS申请/释放的机制,同时通过加锁保证
前言
PageCache层作为C++高并发内存池的最低层,主要承担着对OS的内存请求操作以及对CentralCache层分配内存等操作,这也是C++高并发内存池系列的最后一篇文章,后续会考虑对线程池的进行解决,可以期待一波,嘎嘎嘎
PageCache层
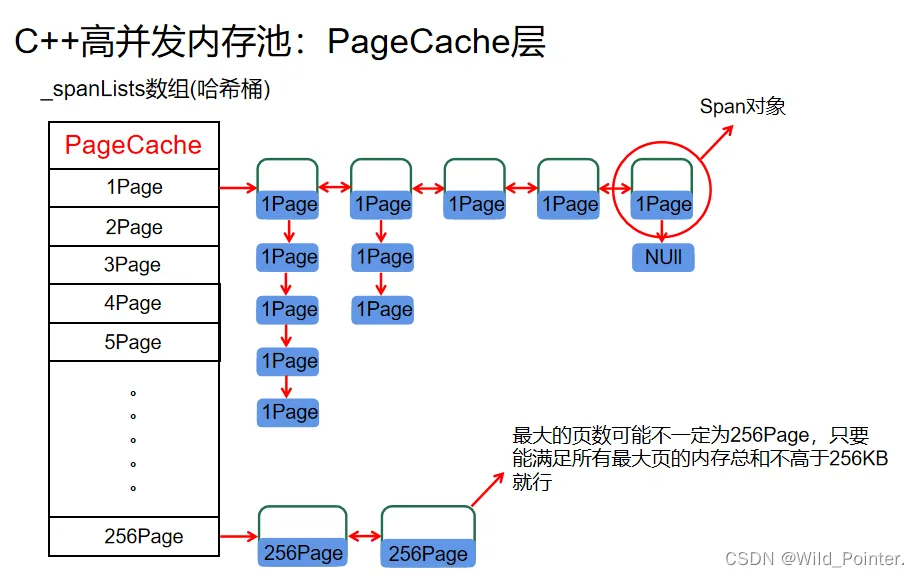
针对PageCache层,我们从前几篇文章中可以了解到,PageCache层的作用主要是分配内存给CentralCache层以及对CentralCache层释放的内存进行管理。在文章《C++高并发内存池实战:初步了解》中我们知道,PageCache层向OS申请内存的大小不同于其他层,一般是以页(Page)为单位,所以针对PageCache层中的内存映射单位也有所不同。但单单对于PageCache层的结构来说,PageCache还是一个哈希桶结构,其中存在一个数组变量管理着对应的内存,且这些数组的元素都指向一个Span双向链表(类似于CentralCache层),所以PageCache层的结构如下图:
图1.PageCache层结构图
在了解PageCache层结构后,我们将对PageCache层进行实现。由上文我们知道,PageCache层不仅要实现对CentralCache层分配内存和对其释放的内存进行管理,我们还需要针对PageCache层设计锁,保证在同一个时间内只有一个来着CentralCache层的哈希桶向PageCache层申请内存,而且我们还需要实现当PageCache层内存不足时,向OS申请内存的接口以及当PageCache层内存多余时,向OS释放内存的接口。在了解我们需要设计的对应接口后,PageCache层设计如下:
static const size_t NPAGES = 256; //最大页数static const size_t PAGE_SHIFT = 13; //通常用来左移转换为一页的大小(指转换为二进制后左移)class PageCache{public: //返回PageCache对象 static PageCache* GetInstance(){ return &_sInst; } //分配内存至CentralCache Span* NewSpan(size_t k); //查询Id映射的Span对象 Span* MapObjectToSpan(void* obj); //管理CentralCache层释放的内存 void ReleaseSpanToPageCache(Span* span);private: SpanList _spanLists[NPAGES]; //哈希桶 std::unordered_map<PAGE_ID, Span*> _idSpanMap;//Id映射容器public: std::mutex _pageMtx;//锁private: PageCache(){} PageCache(const PageCache&) = delete; static PageCache _sInst;//PageCache也采用单例设计模式,全局只存在一个PageCache};在了解PageCache层结构后,将对其为实现的NewSpan(),MapObjectToSpan()和ReleaseSpanToPageCache()进行实现,具体实现的代码如下:
//分配内存至CentralCacheSpan* PageCache::NewSpan(size_t k){ assert(k > 0); if (!_spanLists[k].Empty()){ //检查分配内存映射对应的桶里面是否存在空闲的Span Span* kSpan = _spanLists[k].PopFront(); //建立id和span的映射,方便central cache回收小块内存时,查找对应的span for (PAGE_ID i = 0; i < kSpan->_n; ++i){ _idSpanMap[kSpan->_pageId + i] = kSpan; } return kSpan; } //没有空闲的Span则检查后面的桶里面是否存在空闲的span for (size_t i = k + 1; i < NPAGES; ++i) { if (!_spanLists[i].Empty()){ //把后面桶所含的Span进行切分 Span* nSpan = _spanLists[i].PopFront(); Span* kSpan = new Span; // nSpan再挂到对应映射的位置 kSpan->_pageId = nSpan->_pageId; //在Span的头部切内存为k的页 kSpan->_n = k; //设置span内存大小为k nSpan->_pageId += k; //再把Span挂到对应映射的位置 nSpan->_n -= k; //存储nSpan的首位页号跟nSpan映射,方便page cache回收内存时 _spanLists[nSpan->_n].PushFront(nSpan); _idSpanMap[nSpan->_pageId] = nSpan; _idSpanMap[nSpan->_pageId + nSpan->_n - 1] = nSpan; //建立id和span的映射,方便central cache回收小块内存时,查找对应的span for (PAGE_ID i = 0; i < kSpan->_n; ++i){ _idSpanMap[kSpan->_pageId + i] = kSpan; } return kSpan; } }}//查找ID映射对应的SpanSpan* PageCache::MapObjectToSpan(void* obj){ std::unique_lock<std::mutex> lock(_pageMtx); //对PageCache层加锁 auto ret = _idSpanMap.find(id); // 寻找Id映射对应的Span if (ret != _idSpanMap.end()){ return ret->second;jies //返回定义Span } else{ assert(false); return nullptr; }}//管理CentralCache层释放的内存void PageCache::ReleaseSpanToPageCache(Span* span){ while (1){ //对span前后的页,尝试进行合并,缓解内存碎片问题 PAGE_ID prevId = span->_pageId - 1; //获取前一个页的Id auto ret = _idSpanMap.find(prevId); //知道Id对于的页 if (ret == _idSpanMap.end()){ //释放的内存属于第一个页,不合并 break; } Span* prevSpan = ret; if (prevSpan->_isUse == true){ //前面相邻页的span在使用,不合并 break; } if (prevSpan->_n + span->_n > NPAGES - 1) //合并后大小超过128页,不合并 break; } span->_pageId = prevSpan->_pageId; //将Span起始页的Id更新为前一个页的Id span->_n += prevSpan->_n; //计算合并的大小 _spanLists[prevSpan->_n].Erase(prevSpan);//移除管理的Span delete prevSpan; //删除前一个Span } while (1){ //对Span后的页进行合并 PAGE_ID nextId = span->_pageId + span->_n; //获取后一个页的Id auto ret = (Span*)_idSpanMap.get(nextId); //获取对应Id的Span if (ret == nullptr){ //最后一页,不合并 break; } Span* nextSpan = ret; if (nextSpan->_isUse == true){ //后一个Span正在使用,不合并 break; } if (nextSpan->_n + span->_n > NPAGES - 1){ //合并后大小超过128页,不合并 break; } span->_n += nextSpan->_n; _spanLists[nextSpan->_n].Erase(nextSpan); delete nextSpan; } _spanLists[span->_n].PushFront(span); span->_isUse = false; //将Span状态修改为未使用 _idSpanMap[span->_pageId] = span; _idSpanMap[span->_pageId+span->_n-1] = span;}PS:以上便是PageCache层的实现代码,重点是思路,提供的代码只作参考作用!!!
大于256KB的内存申请和释放
在文章《C++高并发内存池:ThreadCache层》曾对于内存的分配和释放的流程进行讲解,其中在分配的流程图中存在最后一步,即当线程申请的空间大于256KB时,将会直接向PageCache层进行申请和释放,那么在线程请求分配内存时还需要实现对申请256KB的内存进行单独处理,代码如下:
//大于256KB的直接去PageCache上申请if (size > MAX_BYTES){ size_t alignSize = SizeClass::RoundUp(size); //寻找申请内存大小所映射的Span size_t kPage = alignSize >> PAGE_SHIFT; //获取Span的ID PageCache::GetInstance()->_pageMtx.lock(); //给PageCache层加锁 Span* span = PageCache::GetInstance()->NewSpan(kPage); //分配内存 PageCache::GetInstance()->_pageMtx.unlock(); void* ptr = (void*)(span->_pageId << PAGE_SHIFT); return ptr;}//PageCache处理申请大于256KB的内存申请Span* PageCache::NewSpan(size_t k){ assert(k > 0); if (k > NPAGES - 1){ //大于128page的直接向堆申请 void* ptr = SystemAlloc(k); //使用Window申请空间的API Span* span = _spanPool.New(); span->_pageId = (PAGE_ID)ptr >> PAGE_SHIFT; span->_n = k; _idSpanMap.set(span->_pageId, span); return span; } //……}既然存在申请大于256KB的内存,也就存在大于256KB的内存的释放,针对内存的释放,代码如下:
if(size > MAX_BYTES){ //大于256KB的内存释放 Span* span = PageCache::GetInstance()->MapObjectToSpan(ptr); //查找ID映射对应的Span PageCache::GetInstance()->_pageMtx.lock(); PageCache::GetInstance()->ReleaseSpanToPageCache(span); PageCache::GetInstance()->_pageMtx.unlock();}else{ assert(pTLSThreadCache); pTLSThreadCache->Deallocate(ptr, size); //释放内存}if(span->_n > NPAGES - 1){ //大于128 page的直接还给堆 void* ptr = (void*)(span->_pageId << PAGE_SHIFT); SystemFree(ptr); delete span; return;}以上便是本系列的最后一节内容,重点在于理解,对于实际实现高并发的内存池还需要针对具体情况实现,比如当线程频繁申请256KB以上的内存时,那么PageCache层的最大页数就不固定,所以重点是理解,如何实现如何优化还需要依靠实际情况分析